ThomasSeekerAI
Prywatny handlarz codziennie ręcznie przeczesywał OLX, Otomoto, Allegro i kilka mniejszych serwisów w poszukiwaniu rzeczy wartych odsprzedaży. Zbudowaliśmy wewnętrzne narzędzie, które przejmuje tę pracę: wyszukiwania opisane zwykłym zdaniem prowadzi cyklicznie w tle, odsiewa szum i układa resztę według oceny okazji — godziny ręcznego przeglądania zamienione w automat.
- Klient
- Prywatny handlarz i łowca okazji. Aplikacja wewnętrzna, zbudowana pod jedną osobę i jej sposób pracy.
Kontekst projektu
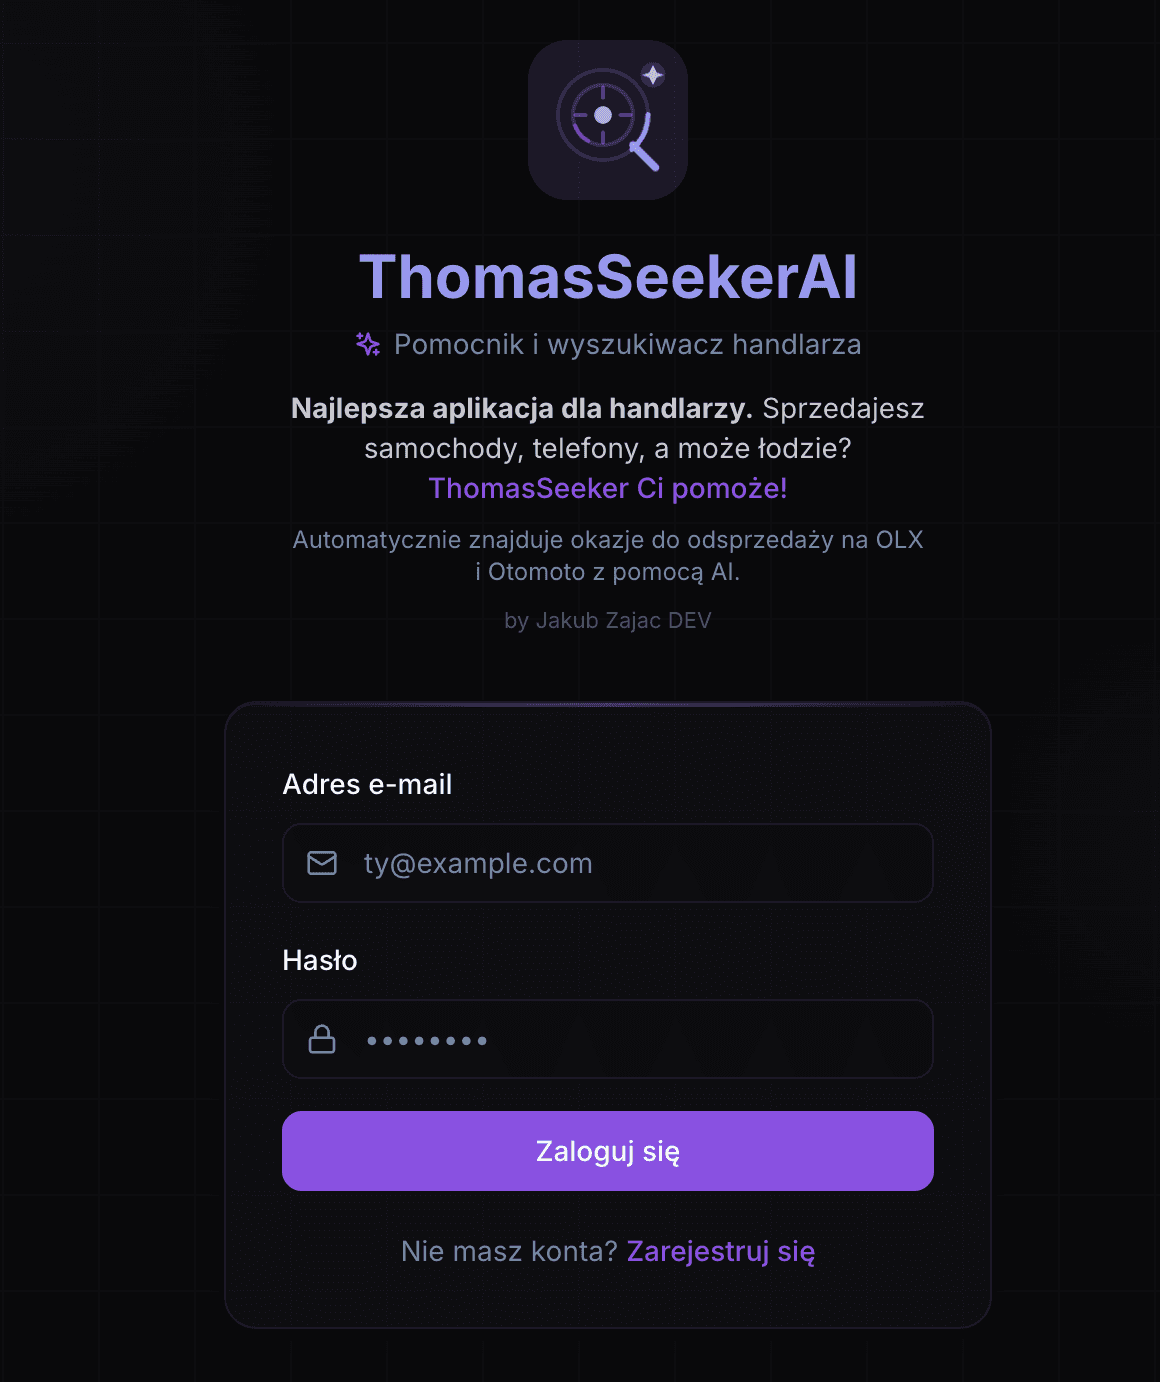
ThomasSeekerAI powstał dla jednej osoby: handlarza, który codziennie przeglądał OLX, Otomoto, Allegro i kilka mniejszych serwisów w poszukiwaniu rzeczy wartych kupienia i odsprzedania. Nie chodzi o jedną kategorię — raz są to samochody i części, innym razem elektronika, narzędzia, meble albo sprzęt. Aplikacja przejmuje tę pracę: prowadzi wyszukiwania w tle, analizuje znalezione ogłoszenia z pomocą AI i pokazuje w jednym miejscu te, które faktycznie wyglądają na okazję.
Wyszukiwanie definiuje się tu opisem, a nie zestawem sztywnych pól. Użytkownik pisze, czego szuka, może dołączyć zdjęcie referencyjne, wskazuje serwisy, budżet, oczekiwany stan i dopuszczalne uszkodzenia. System tłumaczy to na kryteria, według których ocenia kolejne ogłoszenia. To zmienia charakter całości: nie jest to wyszukiwarka po słowach kluczowych, tylko potok, w którym filtrowanie deterministyczne i analiza wspierana przez AI odpowiadają za dwie różne rzeczy.
Zbudowaliśmy całość: warstwę dostawców i scraperów, workera wykonującego wyszukiwania według harmonogramu, normalizację i deduplikację danych, etap analizy AI, scoring oraz interfejs, w którym wyniki, oceny i diagnostyka źródeł stoją obok siebie. Wyniki pojawiają się w samej aplikacji. Zewnętrznego kanału powiadomień nie ma i było to świadome zawężenie zakresu pierwszej wersji.
Wyzwanie biznesowe
Każde źródło jest inne. OLX, Otomoto, Allegro i dodatkowe serwisy mają własną strukturę, własne braki w opisach i własne ograniczenia w pozyskiwaniu danych; jedne da się obsłużyć własnym scraperem, inne wymagają zewnętrznego dostawcy. Do tego ta sama rzecz bywa wystawiona w kilku miejscach naraz, w kilku wariantach i pod różnymi tytułami. Wszystko to trzeba sprowadzić do jednego modelu, zdeduplikować i utrzymać świeże, bo ogłoszenie znalezione dzień później zwykle nie ma już żadnej wartości.
Drugi problem to odróżnienie okazji od szumu. Wyszukiwanie po słowach kluczowych zwraca zalew ogłoszeń, z których większość jest nietrafiona, a ocena „czy to się opłaca” zależy od stanu, uszkodzeń, kompletności i tego, po ile podobne rzeczy chodzą. Tu wchodzi analiza AI, ale nie w roli magicznego filtra. Musiała dostawać do oceny wyłącznie sensownych kandydatów i musiała zostawiać po sobie ślad: dlaczego ta oferta dostała taką ocenę i skąd w ogóle pochodzi. Bez tego pusty wynik jest nie do zinterpretowania — nie wiadomo, czy rynek milczy, czy przestał odpowiadać jeden z dostawców.
Zakres realizacji
Zakres objął całe narzędzie: model danych, warstwę dostawców i scraperów wraz z logiką fallbacku, workera prowadzącego wyszukiwania według harmonogramu, normalizację i deduplikację ogłoszeń, etap analizy AI, scoring oraz responsywną aplikację webową. Backend i frontend napisaliśmy w TypeScripcie, więc kontrakt między nimi jest jeden i sprawdza go kompilator.
Odbiorca był jeden, więc pętla zwrotna była krótka. To, co uznawał za trafienie, a co za pudło, wracało wprost do kryteriów filtrowania i sposobu punktowania ofert — przy narzędziu pisanym pod jedną osobę to materiał lepszy niż jakakolwiek ogólna heurystyka wymyślona przy biurku.
Rola założyciela
Całość zrealizował osobiście założyciel firmy, Jakub Zając — architektura, warstwa dostawców i scraperów, worker, potok normalizacji i analizy oraz interfejs aplikacji.
Zaangażowane kompetencje
- Analiza produktowa i techniczna
- Zamiana listy życzeń w zakres, który da się wycenić i zbudować.
- Architektura rozwiązania
- Decyzje, których nie da się tanio odkręcić po roku działania systemu.
- Frontend
- Aplikacje, które są szybkie i dostępne również na słabym łączu.
- Backend i API
- Logika biznesowa i integracje, które wytrzymują zmianę wymagań.
- DevOps i chmura
- Powtarzalne wdrożenia i środowiska, które da się odtworzyć.
- Bazy danych
- Model danych i zapytania, które nie zwalniają razem ze wzrostem firmy.
Lista dyscyplin, których wymagała ta realizacja — nie lista stanowisk.
Rozwiązanie
Definiowanie wyszukiwań w języku naturalnym
Wyszukiwanie zaczyna się od opisu: użytkownik pisze zwykłym zdaniem, czego szuka, i może dołączyć zdjęcie referencyjne. Resztę doprecyzowuje zestawem pól — nazwa wyszukiwania, interwał uruchamiania, wybrane serwisy lub domeny, maksymalna cena albo budżet, oczekiwany stan, dopuszczalne uszkodzenia, słowa kluczowe, wymagania właściwe dla kategorii oraz minimalna ocena trafności lub okazji, poniżej której oferta w ogóle nie trafia na listę.
Warstwa dostawców i scraperów
Pozyskiwanie danych stoi za osobną warstwą dostawców. OLX obsługuje własny scraper napisany pod jego specyfikę, część źródeł idzie przez Apify, wybrane zewnętrzne strony przez Firecrawl, a dla pozostałych piszemy własne adaptery. Każdy dostawca ma ten sam kontrakt, więc dołożenie kolejnego źródła nie dotyka rdzenia systemu. Gdy dostawca zawiedzie, wchodzi logika fallbacku: przebieg traci zasięg w jednym miejscu, zamiast kończyć się błędem.
Normalizacja, deduplikacja i filtrowanie deterministyczne
Zebrane ogłoszenia trafiają najpierw do normalizacji: ujednolicenie pól, deduplikacja tego samego przedmiotu wystawionego w kilku miejscach, zapisanie przy każdym wpisie dostawcy, od którego pochodzi. Potem idzie filtrowanie deterministyczne — cena, stan, uszkodzenia, wymagania kategorii — i to ono odsiewa większość. Każde odrzucenie zapisuje strukturalny powód, więc wiadomo, co zostało sprawdzone i z jakim wynikiem — listę można czytać także od drugiej strony: dlaczego czegoś na niej nie ma.
Analiza wspierana przez AI i ocena okazji
Kandydaci, którzy przeszli filtry, idą do analizy AI. Najpierw interpretowane jest samo wyszukiwanie — co użytkownik miał na myśli w opisie i na zdjęciu referencyjnym — a potem oceniana konkretna oferta: czy odpowiada opisowi, w jakim jest stanie, co wynika z treści ogłoszenia i jak wypada na tle dostępnego kontekstu rynkowego. Z tego powstaje ocena trafności i ocena okazji, a ranking układa się według nich. Przy każdej pozycji widać, co złożyło się na wynik.
Pulpit wyników i diagnostyka dostawców
Wyniki pojawiają się w aplikacji i to jedyne miejsce, w którym użytkownik je ogląda. Pulpit pokazuje ranking z ocenami i uzasadnieniem, źródło każdej pozycji oraz kontrolki, którymi można oznaczyć trafienie albo pudło. Obok stoi diagnostyka dostawców: co odpowiedziało, co się wysypało i ile ogłoszeń wniósł każdy z nich do ostatniego przebiegu. Dzięki temu wynik pusty i wynik zepsuty wyglądają inaczej, zamiast wyglądać tak samo.
Harmonogram i praca w tle
Wyszukiwania wykonuje worker działający w tle. Każde aktywne wyszukiwanie ma własny interwał, a częstotliwość, z jaką worker sprawdza, co jest do zrobienia, ustawia się w konfiguracji środowiska. Jednocześnie może działać do pięciu aktywnych wyszukiwań. Ten limit jest świadomy: przy narzędziu dla jednej osoby pięć dobrze opisanych wyszukiwań daje więcej niż długa lista zapomnianych. Uruchomienie ręczne pozostaje możliwe, ale nie jest trybem podstawowym — system ma pracować, kiedy nikt na niego nie patrzy.
Stos technologiczny
Backend i workery
- TypeScript
- Background worker
- Scheduled execution
Pozyskiwanie danych
- Custom OLX scraper
- Apify
- Firecrawl
- Custom scraper adapters
- Provider fallback
Baza danych
- PostgreSQL
Analiza AI
- AI-assisted intent interpretation
- AI-assisted offer analysis
- Relevance and opportunity scoring
Interfejs
- TypeScript
- Responsive web application
Podejście techniczne
- 01
Filtrowanie deterministyczne działa przed analizą AI, nie po niej. Cena, stan i wymagania kategorii to reguły, które da się sprawdzić tanio i jednoznacznie, więc do kosztownego etapu trafiają wyłącznie kandydaci, którzy w ogóle mają szansę okazać się okazją.
- 02
Każde odrzucenie niesie strukturalny powód. Wygląda to na drobiazg, dopóki wyszukiwanie nie zwróci zera — wtedy różnica między „nic nie spełniło kryteriów” a „dostawca przestał odpowiadać” jest jedyną różnicą, która się liczy.
- 03
Przy każdym ogłoszeniu zapisujemy dostawcę, od którego pochodzi. Każdy wynik da się więc cofnąć do źródła, a kiedy jedno z nich zaczyna zwracać śmieci, widać to po konkretnych pozycjach, zamiast po ogólnym wrażeniu, że coś jest nie tak.
- 04
Dostawcy są wymienni i mają zdefiniowany fallback. Jedno zawodzące źródło zawęża zasięg przebiegu, ale go nie przerywa. Przy pozyskiwaniu danych z cudzych serwisów awarie źródeł nie są wyjątkiem, tylko normalnym stanem pracy.
- 05
Zewnętrzne kanały powiadomień — e-mail, komunikator, push — są na liście planów, a nie w obecnej wersji: dziś aplikacja pokazuje wyniki wyłącznie we własnym interfejsie.
Jakość i niezawodność
- Pozyskiwanie danych prowadzimy odpowiedzialnie: z ograniczeniem częstotliwości, przewidywalnym ruchem i poszanowaniem zasad korzystania z serwisów. Interwały wyszukiwań są konfigurowalne właśnie po to, żeby dało się je ustawić rozsądnie, a nie maksymalnie.
- Treści ogłoszeń traktujemy jako dane niezaufane. Tytuły, opisy i adresy przechodzą walidację i sanityzację, zanim trafią do bazy, do etapu analizy i do interfejsu — źródłem jest tu cudza strona, a nie formularz, nad którym mamy kontrolę.
- Klucze do dostawców i dane dostępowe do bazy trzymamy poza kodem, w konfiguracji środowiska. Nie trafiają do repozytorium i można je wymienić bez dotykania aplikacji.
- To narzędzie wewnętrzne dla jednego operatora i zakres jest temu podporządkowany: dostęp wymaga zalogowania, aplikacja nie jest publicznym serwisem, a poza treścią samych ogłoszeń — publicznie dostępnych tam, gdzie zostały wystawione — nie gromadzi danych osób trzecich.
Efekt
Zamiast ręcznego objeżdżania kilku serwisów po kilka razy dziennie jest jeden uporządkowany widok: te same kryteria stosowane wszędzie tak samo, bez pilnowania, gdzie się już zaglądało.
Wyszukiwania wykonują się cyklicznie w tle, według interwału ustawionego osobno dla każdego z nich, a nie tylko wtedy, gdy ktoś usiądzie do komputera.
Wyniki przychodzą uszeregowane, z widoczną oceną, uzasadnieniem i informacją, z którego dostawcy pochodzą — dane, na których można oprzeć decyzję o zakupie. Podejmuje ją człowiek, ale ma pod ręką to, na czym system oparł swoją.
Równolegle może działać do pięciu aktywnych wyszukiwań, a dołożenie kolejnego źródła sprowadza się do napisania adaptera — architektura nie jest wąskim gardłem dla dalszej rozbudowy.
Powiązane usługi
Zakres, z którego korzystał ten projekt — opisany szerzej na stronach usług.
Funkcje oparte na modelach językowych — asystenci nad dokumentami firmy, wyszukiwanie wiedzy, wyciąganie danych. Wdrażamy je z ewaluacją, śledzeniem i pilnowaniem kosztów.
Systemy działające w przeglądarce — panele operacyjne, portale klienckie, dashboardy i produkty SaaS — z uprawnieniami, integracjami i wydajnością policzoną pod realne obciążenie.
Kopiowanie danych między systemami, ręczne raporty i przepisywanie dokumentów zamieniamy w skrypty i integracje, które działają same.
Projektowanie i optymalizacja PostgreSQL, migracje, raportowanie i automatyczna walidacja danych — żeby liczby w firmie wreszcie się zgadzały.
Inne realizacje
01Aplikacja lojalnościowa i panel administracyjny
IZAPzoo
Sieć sklepów stacjonarnych IZAP chciała mieć własny program lojalnościowy w telefonach klientów zamiast plastikowych kart. Zaprojektowaliśmy i zbudowaliśmy całość — aplikację na Androida i iOS, backend w chmurze i panel administracyjny — a punkty, nagrody i promocje personel sklepów obsługuje dziś samodzielnie.
Zobacz case study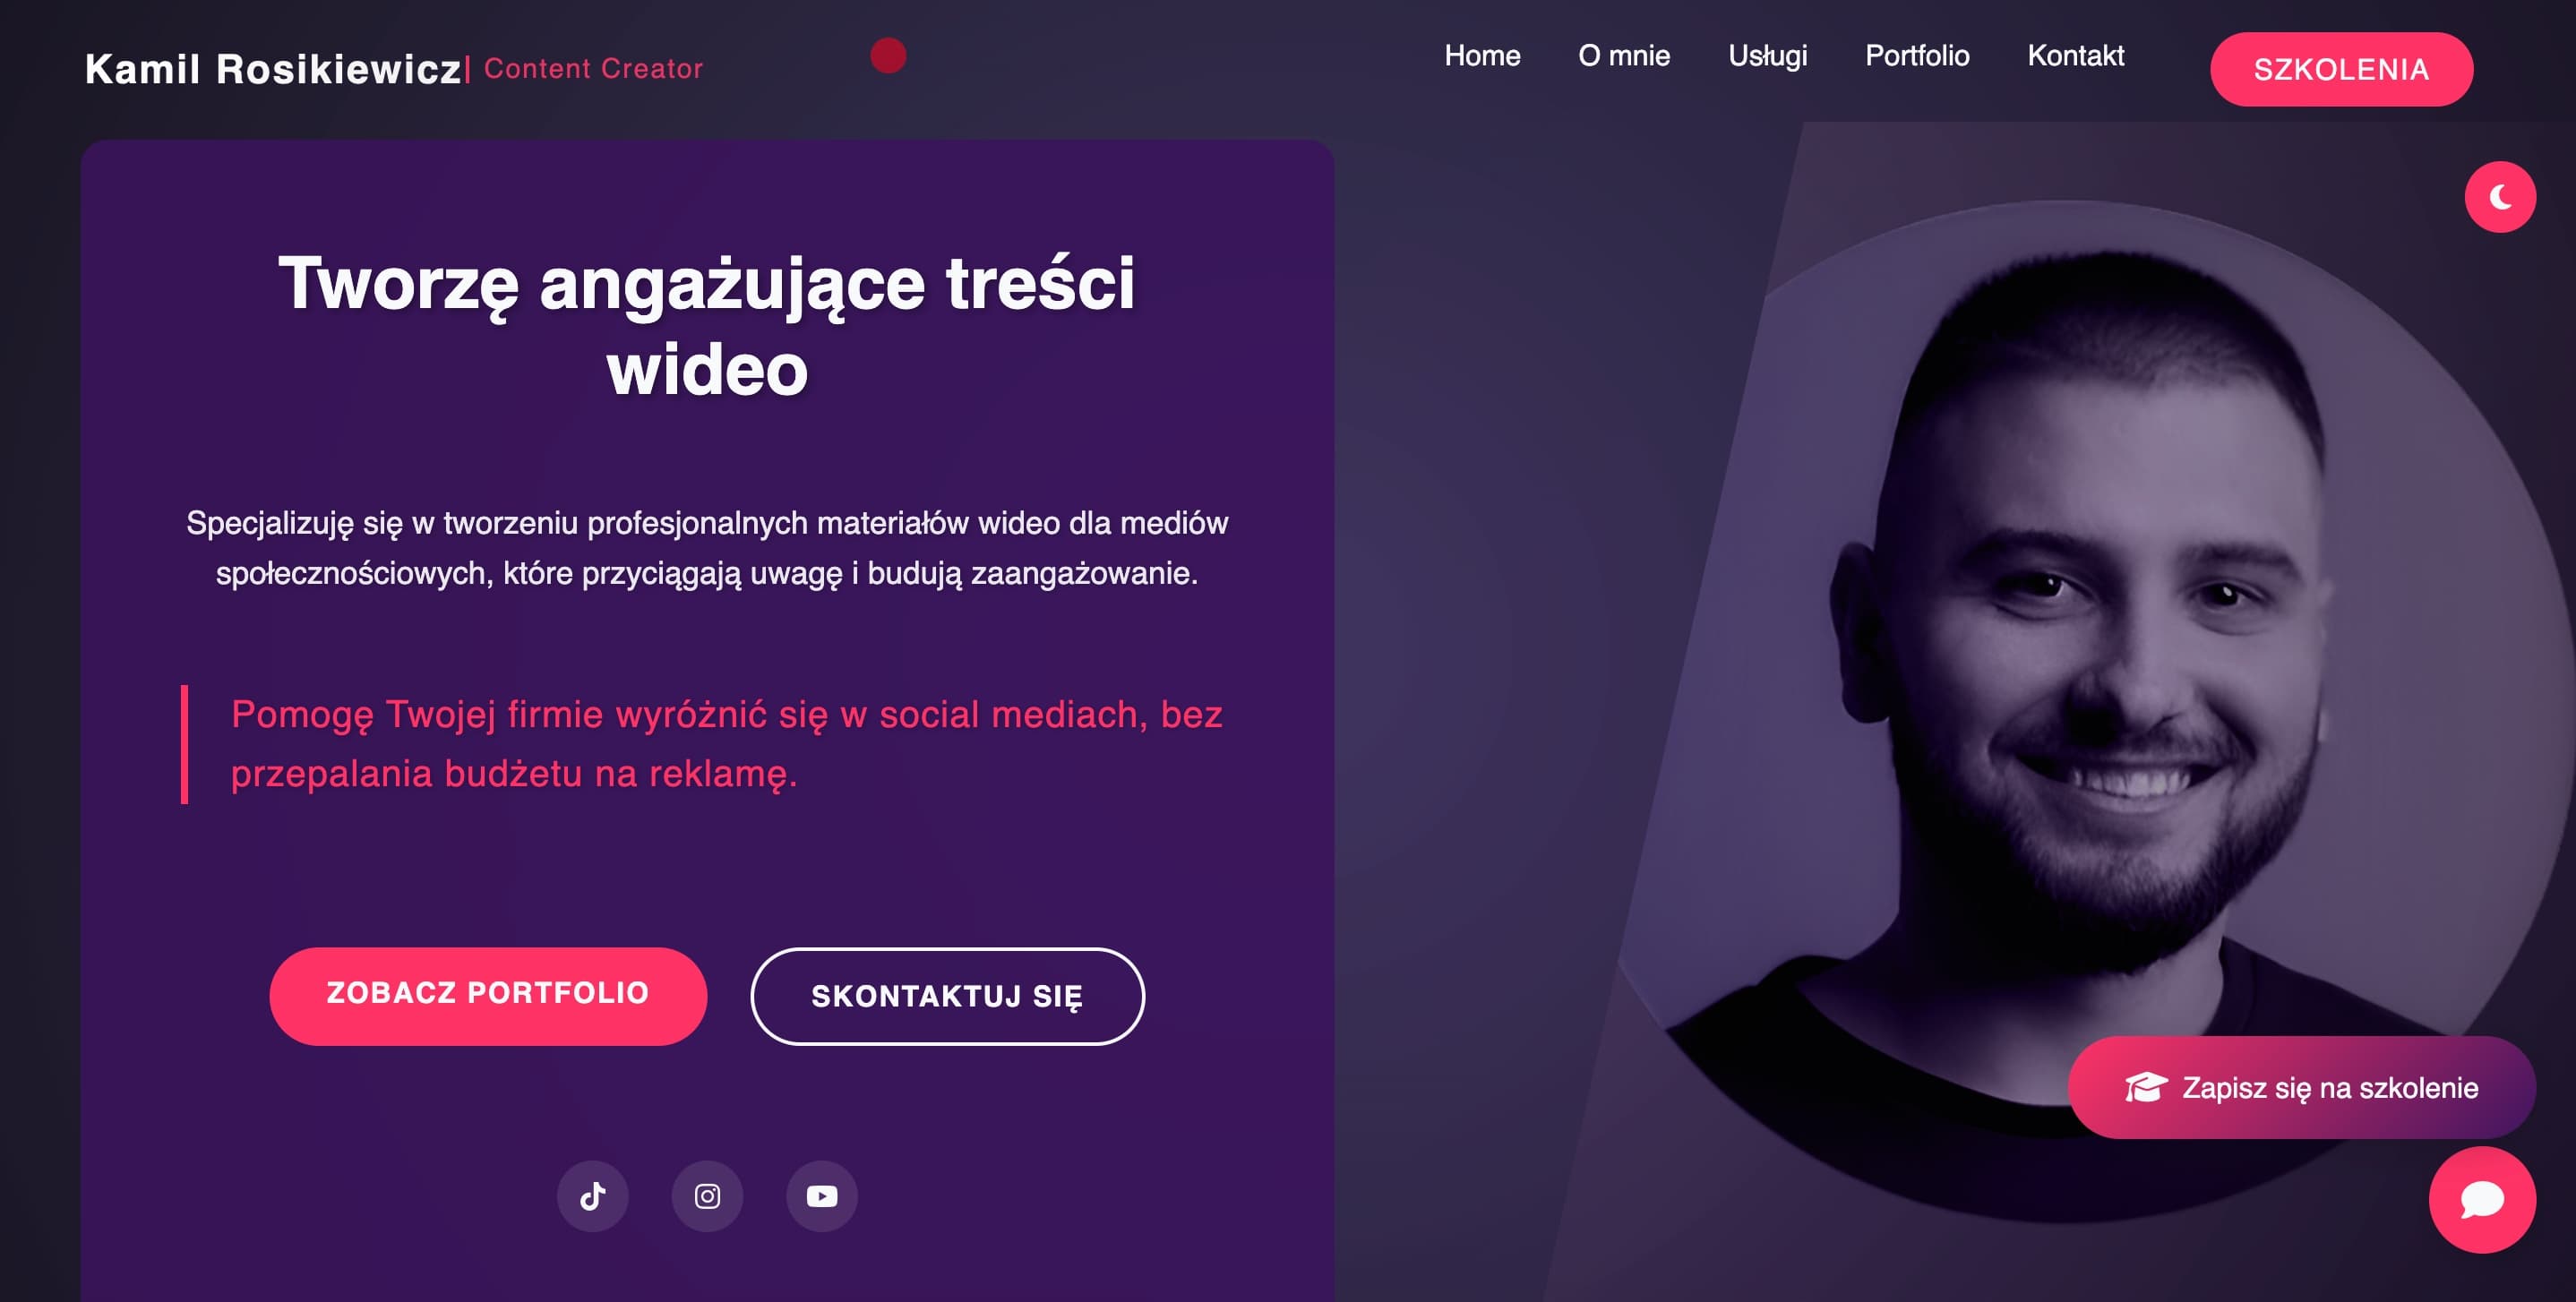
03Strona klienta
Kamil Rosikiewicz
Kamil Rosikiewicz potrzebował strony, która udowadnia jakość obrazem, a mimo to otwiera się szybko także na telefonie. Zbudowaliśmy witrynę, w której portfolio ogląda się jak showreel, a każda podstrona prowadzi odwiedzającego prostą ścieżką do zapytania ofertowego albo do zapisu na szkolenie.
Zobacz case study
Porozmawiajmy o Twoim projekcie
Chętnie opowiemy, jak podobne podejście sprawdziłoby się u Ciebie — i czego byśmy uniknęli.