DevOps Engineering
Większość tych projektów zaczyna się tak samo: ręczne wydania „po godzinach”, środowiska nie do odtworzenia i wiedza o wdrożeniach zamknięta w jednej głowie. Kończy się powtarzalnym procesem: pipeline'ami CI/CD, infrastrukturą opisaną w kodzie i monitoringiem, który zgłasza problemy przed użytkownikami — i wydaniami, przy których nikt nie wstrzymuje oddechu.
- Klient
- Różne organizacje — od małych zespołów produktowych po projekty realizowane w środowiskach enterprise
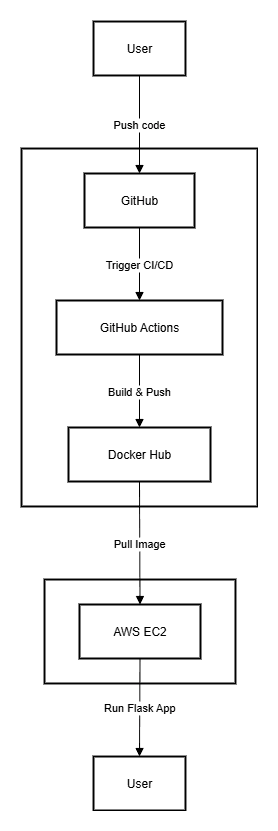
Kontekst projektu
To nie jest opis jednego produktu, tylko przekrój podobnych problemów, które wracają w kolejnych organizacjach: wdrożenia robione ręcznie przez jedną osobę, serwer, którego nikt nie odważa się dotknąć, i środowiska, których nie da się odtworzyć. Ta strona zbiera wybrane wdrożenia z tego obszaru.
Łączy je jedno podejście: droga od commita do produkcji zostaje zautomatyzowana, infrastruktura jest opisana w kodzie, a monitoring odpowiada na pytanie „co się dzieje”, zanim zada je klient. Zamiast bohaterskich akcji przy każdym wydaniu — nudny, powtarzalny proces, który po prostu działa.
Część tych praktyk pochodzi z projektów enterprise — wypracował je założyciel firmy w środowiskach PwC, Roche i E.ON — i tutaj pracują w skali dopasowanej do mniejszych zespołów, bez korporacyjnego narzutu.
Wyzwanie biznesowe
Typowy punkt startowy wygląda podobnie: wydania rzadkie i stresujące, konfiguracja rozjechana między środowiskami, klasyczne „u mnie działa” i błędy wykrywane przez użytkowników zamiast przez system. Wiedza o tym, jak wdrożyć aplikację, mieszka w głowie jednej osoby — co jest ryzykiem dla firmy, a nie tylko niewygodą.
Prawdziwym wyzwaniem nie są narzędzia, tylko zmiana procesu bez zatrzymywania pracy. Automatyzację trzeba wprowadzać do żywego projektu — etapami, bez wielotygodniowego zamrożenia rozwoju — i tak, żeby po zakończeniu współpracy zespół umiał ten proces samodzielnie utrzymać.
Zakres realizacji
Zakres takiej współpracy obejmuje projekt rozwiązania i jego uruchomienie: pipeline'y CI/CD, definicje infrastruktury w kodzie, konfigurację środowisk i monitoring. Pracujemy bezpośrednio z programistami i właścicielami systemów, bez warstwy pośredników i bez przejmowania cudzej pracy — automatyzację wprowadzamy do żywego projektu etapami.
Do zakresu należy również to, co zostaje po zakończeniu współpracy: dokumentacja, przejrzyste definicje w repozytorium i sesje przekazania wiedzy. Proces ma należeć do zespołu klienta — jeżeli po naszym wyjściu wdrożenie znowu wymaga jednego konkretnego człowieka, praca nie została dokończona.
Rola założyciela
Prace projektowe i wdrożeniowe prowadzi osobiście założyciel firmy, Jakub Zając — pipeline'y, definicje infrastruktury, konfiguracja środowisk i monitoring — współpracując bezpośrednio z programistami i właścicielami systemów po stronie klienta.
Zaangażowane kompetencje
- Analiza produktowa i techniczna
- Zamiana listy życzeń w zakres, który da się wycenić i zbudować.
- Architektura rozwiązania
- Decyzje, których nie da się tanio odkręcić po roku działania systemu.
- Inżynieria jakości
- Wiedza, co jest przetestowane — i co świadomie nie jest.
- DevOps i chmura
- Powtarzalne wdrożenia i środowiska, które da się odtworzyć.
Lista dyscyplin, których wymagała ta realizacja — nie lista stanowisk.
Rozwiązanie
Pipeline'y CI/CD w GitHub Actions
Każda zmiana w kodzie przechodzi automatycznie przez budowanie, testy i kontrole jakości, a wdrożenie na środowisko sprowadza się do zatwierdzenia. Definicje pipeline'ów żyją w repozytorium obok kodu, więc podlegają review i mają pełną historię zmian.
Konteneryzacja z Dockerem
Aplikacje są pakowane w obrazy Dockera, dzięki czemu ten sam artefakt przechodzi od maszyny programisty, przez testy, aż na produkcję. Problem „u mnie działa” znika, bo wszędzie uruchamiany jest dokładnie ten sam obraz.
Infrastruktura jako kod z Terraform
Zasoby chmurowe w AWS są opisane w Terraformie: sieci, usługi, uprawnienia i konfiguracja powstają z kodu, a nie z klikania w konsoli. Nowe środowisko można postawić z tych samych modułów, a każda zmiana infrastruktury przechodzi przez review jak zwykły kod.
Środowiska, konfiguracja i sekrety
Podział na środowiska deweloperskie, testowe i produkcyjne zostaje uporządkowany: konfiguracja zależy od środowiska, a sekrety trafiają do przeznaczonych do tego magazynów zamiast do plików i wiadomości. Dzięki temu wiadomo, co gdzie działa i z jakimi ustawieniami.
Monitoring i alerty
Systemy dostają metryki, zbieranie logów i alerty oparte m.in. o Amazon CloudWatch — skonfigurowane tak, żeby powiadomienie trafiało do właściwej osoby z informacją, co zrobić. Celem jest dowiadywać się o problemach od monitoringu, a nie od klientów.
Proces wydań i wycofywania zmian
Wydania stają się małe, częste i wersjonowane, z jasno opisaną procedurą powrotu do poprzedniej wersji. Kiedy wycofanie zmiany zajmuje minuty i nie wymaga nerwów, zespół przestaje bać się wdrażać — i paradoksalnie popełnia mniej błędów.
Stos technologiczny
CI/CD i automatyzacja
- GitHub Actions
- Docker
- Bash
Chmura i infrastruktura jako kod
- AWS
- Terraform
Monitoring i obserwowalność
- Amazon CloudWatch
Warsztat codzienny
- Git
- GitHub
Podejście techniczne
- 01
Cała automatyzacja mieszka w repozytorium obok kodu — bez konfiguracji wyklikanej w panelach, której nikt później nie potrafi odtworzyć ani zaudytować.
- 02
Terraform od pierwszego dnia, nawet przy małej infrastrukturze. Opisanie trzech zasobów w kodzie kosztuje godziny; importowanie po roku ręcznych zmian — tygodnie.
- 03
Artefakt budowany jest raz i promowany przez kolejne środowiska — na produkcję trafia dokładnie to, co przeszło testy, a nie „to samo, zbudowane jeszcze raz”.
- 04
Sprawdzone, dobrze udokumentowane usługi wygrywają z modnymi nowościami. Ten proces ma utrzymywać zespół klienta długo po przekazaniu, więc próg wejścia ma znaczenie.
- 05
Alerty są projektowane pod działanie: każdy ma odbiorcę i opisany pierwszy krok reakcji. Alarm, który tylko szumi, uczy zespół ignorowania alarmów.
Jakość i niezawodność
- Uprawnienia według zasady najmniejszego dostępu: pipeline'y i usługi dostają dokładnie te uprawnienia w AWS, których potrzebują — bez współdzielonych kluczy administratora.
- Sekrety nigdy nie trafiają do repozytorium. Żyją w przeznaczonych do tego magazynach sekretów, z możliwością rotacji bez zmian w kodzie.
- Środowiska są od siebie odizolowane — produkcja nie dzieli zasobów ani danych ze środowiskami testowymi „dla wygody”.
- Zmiany w infrastrukturze przechodzą przez review kodu, co daje pełny ślad audytowy: kto, co i dlaczego zmienił.
Efekt
Wdrożenie przestaje być wydarzeniem. Wydania stają się rutyną: małe, odwracalne i możliwe do wykonania przez każdą uprawnioną osobę w zespole, nie tylko przez „tego jednego admina”.
Środowiska dają się odtworzyć z kodu — postawienie nowego środowiska albo odbudowa po awarii to procedura, a nie archeologia po ręcznie konfigurowanych serwerach.
Zespół klienta rozumie i samodzielnie utrzymuje cały proces, bo dostaje go z dokumentacją i przekazaniem wiedzy, a nie jako czarną skrzynkę — to system, który może przejąć każdy kolejny zespół.
Galeria
Przebieg pipeline'u w GitHub Actions (zanonimizowany)
1920×1080 px, AVIF/WebP
Struktura modułów Terraform w repozytorium (zanonimizowana)
1600×1000 px, AVIF/WebP
Dashboard monitoringu z metrykami i alertami (zanonimizowany)
1920×1080 px, AVIF/WebP
Powiązane usługi
Zakres, z którego korzystał ten projekt — opisany szerzej na stronach usług.
CI/CD, Docker, Terraform i AWS — żeby wdrożenia były jednym kliknięciem, a o awariach wiedzieć przed klientami, nie od nich.
Kopiowanie danych między systemami, ręczne raporty i przepisywanie dokumentów zamieniamy w skrypty i integracje, które działają same.
Inne realizacje
01Aplikacja lojalnościowa i panel administracyjny
IZAPzoo
Sieć sklepów stacjonarnych IZAP chciała mieć własny program lojalnościowy w telefonach klientów zamiast plastikowych kart. Zaprojektowaliśmy i zbudowaliśmy całość — aplikację na Androida i iOS, backend w chmurze i panel administracyjny — a punkty, nagrody i promocje personel sklepów obsługuje dziś samodzielnie.
Zobacz case study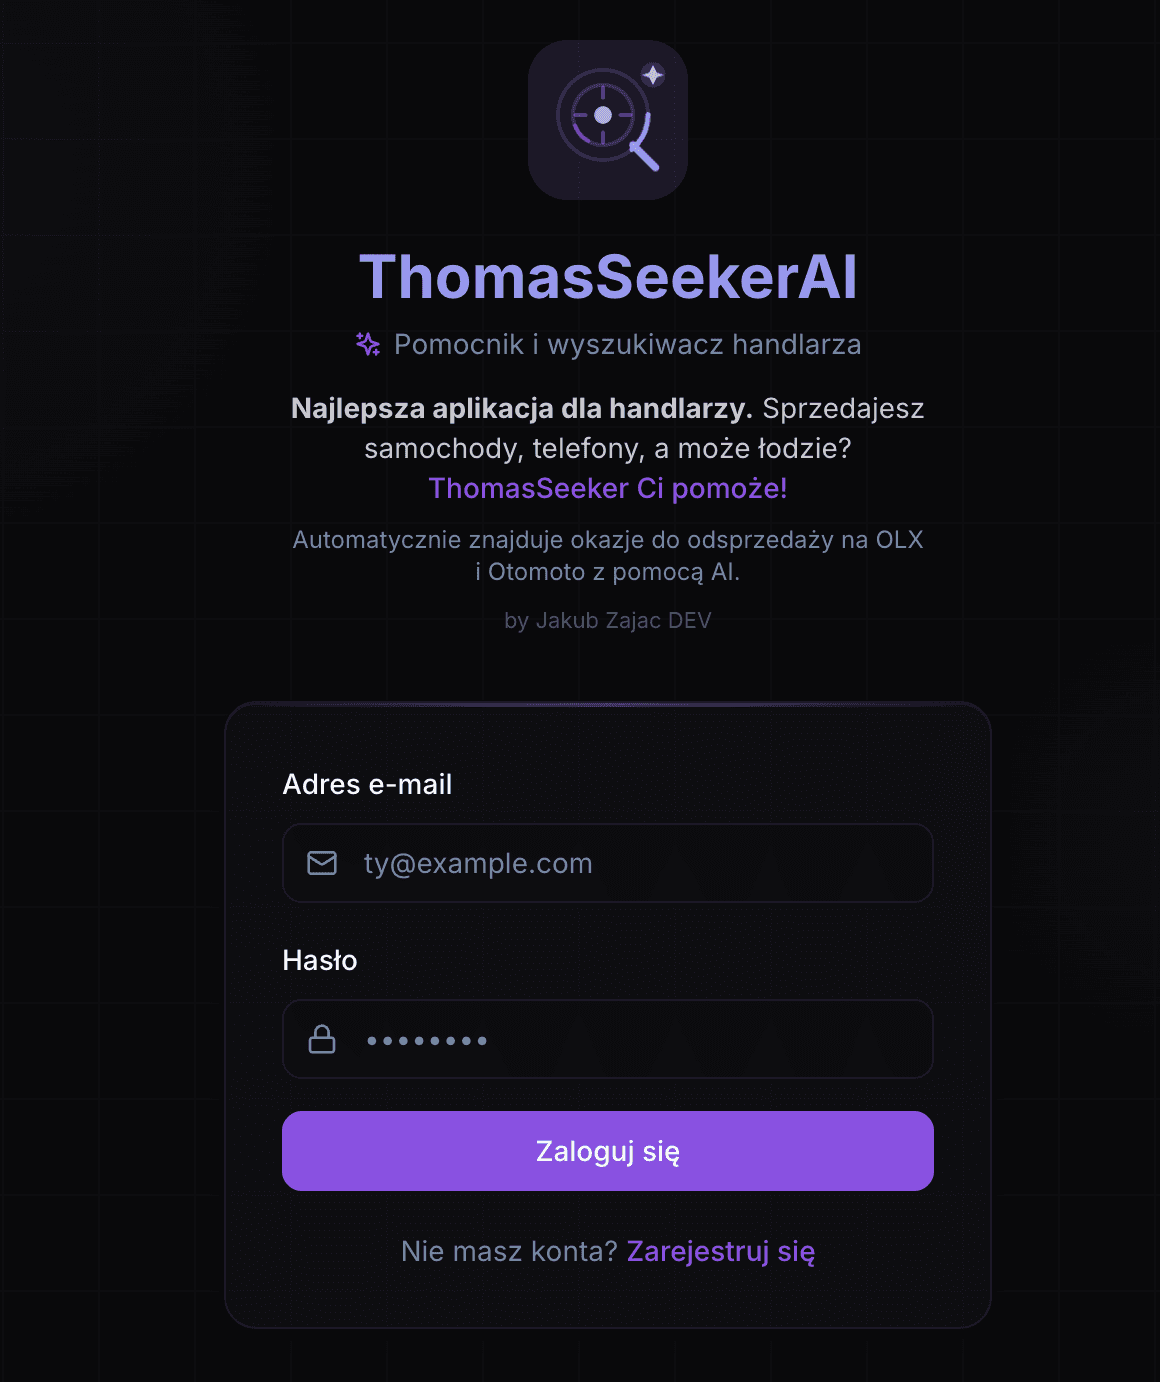
02Prywatne narzędzie do wyszukiwania okazji z analizą AI
ThomasSeekerAI
Prywatny handlarz codziennie ręcznie przeczesywał OLX, Otomoto, Allegro i kilka mniejszych serwisów w poszukiwaniu rzeczy wartych odsprzedaży. Zbudowaliśmy wewnętrzne narzędzie, które przejmuje tę pracę: wyszukiwania opisane zwykłym zdaniem prowadzi cyklicznie w tle, odsiewa szum i układa resztę według oceny okazji — godziny ręcznego przeglądania zamienione w automat.
Zobacz case study
Porozmawiajmy o Twoim projekcie
Chętnie opowiemy, jak podobne podejście sprawdziłoby się u Ciebie — i czego byśmy uniknęli.